 WhatsApp
 Spotify
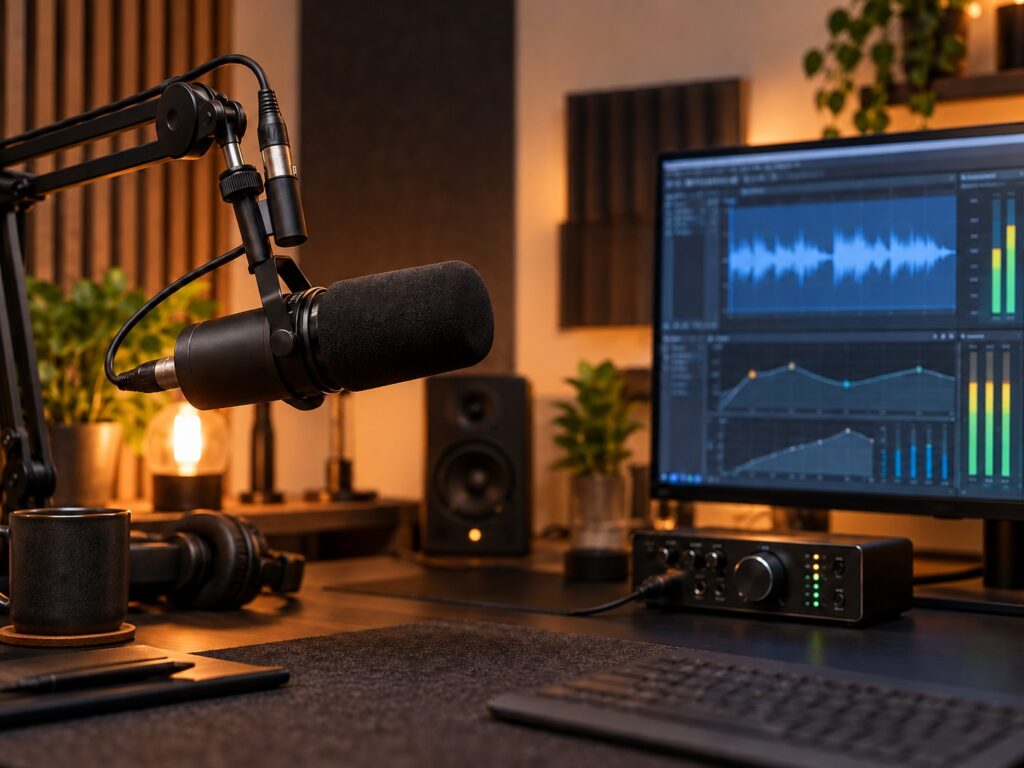
Eine gute Podcast-Stimme entsteht nicht erst im Schnitt. Das Mikrofon, der Raum, der Abstand zum Mikrofon und eine sinnvolle Bearbeitung greifen ineinander. Eine Vocal Chain soll dabei nicht aus einer normalen Stimme eine künstliche Radiostimme machen. Ihr Job ist viel einfacher: störende Anteile reduzieren, die Verständlichkeit erhöhen und die Lautstärke konstant halten.
Die wichtigste Regel vorweg: Eine gute Aufnahme braucht nur wenig Bearbeitung. Wenn der Raum stark hallt, das Mikrofon falsch positioniert ist oder der Pegel permanent übersteuert, kann auch die beste Plugin-Kette das nicht glaubwürdig retten.
Die Podcast Vocal Chain im Überblick
Für die meisten Sprachaufnahmen funktioniert diese Reihenfolge sehr zuverlässig:
- Schnitt und Pegelkorrektur
- High-Pass-Filter und korrigierender EQ
- De-Esser
- Kompressor
- optional: sanfte Klangfärbung oder Sättigung
- Limiter
- Lautheitskontrolle
Nicht jedes Element muss stark arbeiten. Gerade bei einer ruhigen, gut aufgenommenen Stimme kann die Kette ausgesprochen dezent bleiben.
1. Erst die Aufnahme: Mikrofonposition und Pegel
Sprich nicht direkt frontal in die Mikrofonkapsel. Positioniere das Mikrofon leicht seitlich, ungefähr im 30- bis 45-Grad-Winkel. So treffen harte Luftstöße bei P-, T- und B-Lauten nicht direkt auf die Membran. Ein Poppschutz bleibt trotzdem Pflicht.
Als Ausgangspunkt funktionieren etwa 10 bis 15 Zentimeter Abstand bei einem dynamischen Mikrofon und 15 bis 20 Zentimeter bei einem Großmembran-Kondensatormikrofon gut. Entscheidend ist, dass der Abstand während der Aufnahme möglichst gleich bleibt. Wer beim Erzählen ständig vor und zurückwandert, macht dem Kompressor später unnötig Arbeit. Beim Einpegeln sollte die Stimme im Normalfall ungefähr bei -18 bis -12 dBFS liegen; lautere Stellen dürfen kurz in Richtung -6 dBFS gehen. Lass genügend Reserve und nimm nicht „so heiß wie möglich“ auf. Digitales Clipping klingt unangenehm und lässt sich kaum sauber reparieren.
2. Schnitt, Atmer und grobe Pegelsprünge
Bevor Plugins ins Spiel kommen, lohnt sich ein sauberer Schnitt. Entferne Versprecher, lange Denkpausen, deutlich hörbare Mausklicks und störende Nebengeräusche. Atmer musst Du nicht vollständig löschen. Ein Podcast ohne Atemgeräusche wirkt schnell unnatürlich und nervös geschnitten.
Zu laute Einatmer kannst Du eher um 4 bis 8 dB absenken. Dasselbe gilt für einzelne Wörter, die viel lauter gesprochen wurden als der Rest. Kleine manuelle Pegelkorrekturen vor dem Kompressor sorgen dafür, dass dieser musikalischer und unauffälliger arbeitet.
3. EQ: Aufräumen, nicht schönfärben
Der erste EQ in der Podcast Vocal Chain ist vor allem ein Werkzeug zum Aufräumen. Arbeite behutsam und höre immer im Kontext der gesamten Stimme, nicht nur auf problematische Frequenzen im Solo-Modus.
Low-Cut gegen Trittschall und Rumpeln
Ein High-Pass-Filter entfernt tiefe Frequenzen, die für Sprachverständlichkeit meist keine Rolle spielen: Trittschall, Tischvibrationen, Klimaanlagen oder tiefe Plosivlaute. Bei einer Männerstimme kannst Du oft zwischen 60 und 80 Hz beginnen, bei einer höheren Stimme eher zwischen 80 und 100 Hz. Setze den Filter nicht unnötig hoch: Wird zu viel abgeschnitten, verliert die Stimme Wärme und Körper.
Mumpfigkeit und Boxigkeit reduzieren
Wenn eine Stimme dumpf oder zu nah klingt, liegt das Problem oft im unteren Mittenbereich:
- 120 bis 250 Hz: Hier sitzt häufig zu viel Nähe, Wärme oder „Mumpf“.
- 250 bis 500 Hz: Dieser Bereich kann die Stimme boxig, topfig oder etwas nasal wirken lassen.
Eine moderate Absenkung von 1 bis 3 dB mit einem breiten EQ-Band reicht häufig schon. Suche die störende Stelle, indem Du das Band kurz anhebst und durch den Frequenzbereich bewegst. Danach nicht übertreiben: Die Stimme soll weiterhin nach Mensch klingen, nicht nach Telefon.
Sprachverständlichkeit gezielt stärken
Die wichtigsten Informationen für Konsonanten und Artikulation sitzen meist im Präsenzbereich:
- 2 bis 4 kHz: Mehr Durchsetzungskraft und bessere Verständlichkeit.
- 4 bis 6 kHz: Mehr Definition, aber auch der Bereich, in dem Stimmen schnell scharf werden können.
- 10 bis 14 kHz: Ein sehr sanfter High-Shelf kann bei einer dunklen, hochwertigen Aufnahme etwas „Luft“ ergänzen.
Ein breiter Boost von 1 bis 2 dB bei etwa 3 kHz kann einer etwas zurückhaltenden Stimme helfen. Bei vielen dynamischen Podcast-Mikrofonen ist das aber gar nicht nötig. Hör genau hin, ob die Stimme wirklich klarer wird oder nur aggressiver.
4. De-Esser: S-Laute kontrollieren
S-, Sch- und Z-Laute werden durch eine Anhebung im Präsenzbereich und durch Kompression oft auffälliger. Hier kommt der De-Esser ins Spiel. Er reduziert hohe Frequenzen nur dann, wenn sie zu stark hervortreten. Je nach Stimme liegt der problematische Bereich häufig zwischen 5 und 8 kHz. Stelle den De-Esser so ein, dass er bei scharfen S-Lauten etwa 2 bis 5 dB reduziert. Wenn die Stimme danach lispelt oder matt wird, arbeitet er zu stark oder im falschen Frequenzbereich.
Ein De-Esser ist kein Dauer-EQ. Er soll nur störende Spitzen abfangen. Bei sehr scharfen Aufnahmen kann ein zweiter, sanfter De-Esser nach dem Kompressor sinnvoll sein, meistens genügt aber einer.
5. Kompressor: Der rote Faden für Deine Lautstärke
Der Kompressor ist das Herzstück einer Podcast Vocal Chain. Er fängt Pegelspitzen ab und hebt leisere Passagen im Verhältnis an. Dadurch bleibt die Stimme auch bei längeren Gesprächen angenehm verständlich, ohne dass Hörerinnen und Hörer dauernd lauter oder leiser stellen müssen.
Als zuverlässiger Ausgangspunkt:
- Ratio: 2:1 bis 3:1
- Attack: 15 bis 30 Millisekunden
- Release: 80 bis 150 Millisekunden oder Auto-Release
- Gain Reduction: im Durchschnitt etwa 3 bis 6 dB
- Knee: weich, wenn verfügbar
Eine zu kurze Attack-Zeit nimmt der Stimme ihre natürlichen Konsonanten und lässt sie stumpf wirken. Eine zu hohe Ratio klingt schnell gedrückt. Für Podcasting ist gleichmäßig meist wichtiger als spektakulär. Bei sehr dynamischen Sprecherinnen oder Sprechern kann eine zweistufige Kompression angenehmer sein: Der erste Kompressor fängt sanft etwa 2 bis 3 dB ab, der zweite kümmert sich um einzelne lautere Spitzen. So muss kein einzelnes Plugin übertrieben stark arbeiten.
6. Optional: Sättigung für etwas Dichte
Eine sehr dezente Bandsättigung, Röhrensimulation oder Preamp-Emulation kann die Stimme etwas dichter und präsenter machen. Gerade bei einem neutralen dynamischen Mikrofon kann das schön funktionieren. Hier gilt allerdings: weniger als Du denkst. Wenn Du den Effekt deutlich hörst, ist er für einen klassischen Gesprächspodcast oft schon zu stark. Eine gute Sättigung macht die Stimme nicht hörbar „vintage“, sondern hilft ihr, sich auf kleinen Lautsprechern etwas besser durchzusetzen.
7. Limiter: Nur das Sicherheitsnetz
Der Limiter steht am Ende der Kette und schützt vor einzelnen Pegelspitzen. Er sollte nicht den Job des Kompressors übernehmen. Setze den Output beispielsweise auf -1 dBTP, damit beim Export und bei der späteren Wiedergabe genügend Reserve bleibt. Wenn der Limiter regelmäßig mehr als 2 bis 3 dB wegdrückt, überprüfe lieber die Vorstufen: Vielleicht braucht die Aufnahme etwas mehr manuelle Pegelkorrektur oder eine sinnvollere Kompression.
8. Lautheit: Nicht einfach nur laut machen
Ein Podcast sollte auf Kopfhörern, im Auto und auf kleinen Bluetooth-Lautsprechern angenehm und konsistent klingen. Als praxisnaher Zielwert für viele Stereo-Podcasts gelten etwa -16 LUFS integriert, für Mono-Podcasts etwa -19 LUFS integriert.
Wichtig ist nicht, jeden Wert exakt zu treffen, sondern eine konsistente Lautheit von Folge zu Folge zu erreichen. Ein Loudness-Meter am Ende der Kette hilft dabei deutlich mehr als der Blick auf den normalen Peak-Meter.
Beispiel-Chain als Startpunkt
Für eine sauber aufgenommene männliche Podcast-Stimme könnte Deine Kette so aussehen:
- High-Pass bei 70 Hz
- -2 dB bei 220 Hz, breitbandig
- +1,5 dB bei 3 kHz, breitbandig
- De-Esser bei etwa 6,5 kHz mit 3 dB Reduktion
- Kompressor mit 3:1, 20 ms Attack, 100 ms Release und 4 dB Gain Reduction
- optional sehr leichte Sättigung
- Limiter bei -1 dBTP
- Aussteuerung auf etwa -16 LUFS integriert
Das ist kein starres Rezept. Eine hohe, helle Stimme benötigt oft weniger Präsenzanhebung und eine sorgfältigere De-Essing-Einstellung. Eine dunkle Stimme verträgt dagegen möglicherweise etwas mehr Klarheit im Bereich zwischen 2 und 4 kHz.
Die häufigsten Fehler bei der Podcast-Bearbeitung
Der häufigste Fehler ist zu viel Bearbeitung. Ein extremer Low-Cut, zu viel Kompression und ein aggressiver De-Esser führen schnell zu einer dünnen, leblosen Stimme.
Auch ein starker Hall ist bei gesprochenen Podcasts selten sinnvoll. Wenn der Raum hörbar klingt, ist es besser, die Aufnahmeumgebung zu verbessern: Vorhänge, Teppiche, ein Regal mit Büchern, Absorber oder ein besser gewählter Mikrofonplatz helfen mehr als künstlicher Raumklang.
Und: Beurteile Deine Chain nicht nur auf Studiokopfhörern. Höre die fertige Episode auch auf normalen In-Ears, einem Bluetooth-Speaker und im Auto. Wenn die Stimme überall gut verständlich, aber nicht aufdringlich klingt, bist Du auf dem richtigen Weg.
Fazit
Die perfekte Podcast Vocal Chain besteht nicht aus möglichst vielen Plugins, sondern aus wenigen, nachvollziehbaren Schritten. Eine gute Aufnahme wird mit High-Pass und EQ aufgeräumt, mit einem De-Esser gezähmt, sanft komprimiert und am Ende sicher auf Lautheit gebracht. Wenn die Stimme dabei natürlich bleibt und ihre Persönlichkeit behält, klingt der Podcast professionell – ohne nach überproduziertem Radio zu klingen.
Externer Link: Produkte für deinen eigenen Podcast auf MUSIC STORE professional ansehen
Unsere neuesten Beiträge
Die perfekte Podcast Vocal Chain für deinen Podcast
Eine gute Podcast-Stimme entsteht nicht erst im Schnitt. Das Mikrofon, der Raum, der Abstand zum [...]
> WEITERLESENWaldorf Crema: String-Ensemble trifft Wavetable und FM
Mit Crema stellt Waldorf einen Desktop-Synthesizer für Flächen, Streicher und bewegte Klangtexturen vor. Die neue [...]
> WEITERLESENYamaha PSR-A700: Neuer Arranger mit orientalischen Sounds
Yamaha stellt mit dem PSR-A700 ein Arranger-Keyboard für orientalische Musik vor. Das Instrument kombiniert 61 [...]
> WEITERLESEN